
工业大模型的热潮中,智能问数几乎成为企业落地的标配场景。但从原型演示时的“惊艳”,到生产环境往往“平庸”,差距很大。原因在于Agent缺乏可执行、可治理、可复用的业务约束环境——即Harness。许多项目仍停留在“上下文工程”的旧范式,忽视了Agent作为自治体所需的语义基础设施、工具边界与隐性业务契约的系统规划。
本系列文章基于一线实践经验,提出一套“角色Harness与语义Harness双驱动”的Agent工程方法,帮助工业智能问数从Demo走向生产提供可复制的工程化路径。全文分为三篇:第一篇剖析现状,分析现有技术路线为何常陷困局,说明从上下文工程到Harness工程的转变;第二篇聚焦需求,探讨如何通过角色驱动识别Agent真正需要代理的业务决策;第三篇落地实施,阐述如何构建面向Agent的语义基础设施与可复用Harness体系。
01|Agentic数据分析的技术图景与投产鸿沟
数据问答已从大语言模型(LLM)的演示功能,变成企业Agent落地的“标配”场景。但麻省理工学院(MIT)媒体实验室Project NANDA在2025年的调研报告显示,300多个公开披露的AI项目中,仅5%真正投入生产。在智能问数领域尤其明显:“3天完成演示,半年上不了生产”。
原型阶段往往看起来不错:接入RAG、编排几个工具链、微调若干Prompt,Text2SQL跑通,非技术人员也能用自然语言查数。但投产后,Agent的短板立即暴露:①广而不深,能覆盖多维度,但缺乏支撑生产决策的深度;②泛而不全,能回答大量问题,却在关键业务边界上“掉链子”;③对而不稳,生成的SQL或工具调用大部分正确,但面对复杂约束时稳定性不足,缺乏可预期的行为边界。
问题的根源,在于执行环境(Harness)的缺失。早期业界聚焦“上下文工程”(Context Engineering),试图通过提示词、RAG、记忆等手段为模型补充信息。但进入Agent时代,模型不再是被动应答者,而是主动调用工具、编排工作流、执行多步推理的自治体。此时,仅靠“上下文”已不足以约束其行为,我们需要的是Harness工程:一套将业务语义、决策逻辑、工具边界与治理规则,转化为Agent可执行、可校验、可复用的约束框架。
02|现有技术路线的Harness缺口
当前主流路线均有其能力边界,本质上是Harness完备性的差异。
2.1 RAG+Text2SQL:裸模型交互的“天花板”
RAG通过“检索+生成”提升回答准确性,Text2SQL将自然语言转换为SQL,使非技术人员能与数据库交互。该路线在数据库结构简单、问题边界清晰的场景下表现良好。但工业现场的查询常涉及跨表关联、隐性过滤条件或因果推理(如“当前电解槽不稳的原因是什么”),其基于向量相似性的模糊匹配容易导致意图理解偏差,且缺乏对工具调用行为的硬约束。
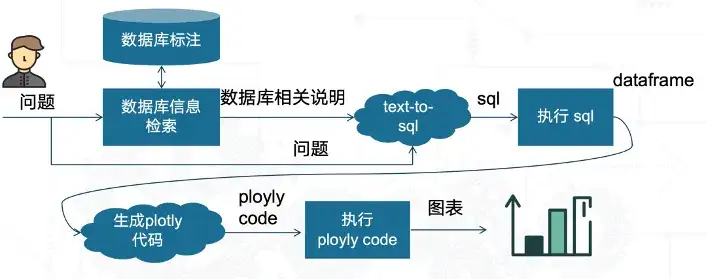
近年的重要演进:NL2Semantic2SQL与Text2DSL。为克服直接面向物理表结构的脆弱性,业界涌现出经“语义层”转译的架构,将业务指标、维度、计算逻辑预先定义,Agent仅在语义框架内生成查询。这实质是在数据层之上构建了一层语义Harness,有效缓解了口径漂移问题。但语义层建设本身需要前期投入,对数据治理成熟度较低的企业而言,成本不低。
2.2 KAG与知识图谱:推理增强与Harness工程代价
知识增强生成(KAG)整合结构化知识图谱(KG),通过逻辑推理生成答案,能克服传统RAG的模糊性。但KAG的前提是领域知识图谱的完备构建。自底向上法噪声大、准确性低,自顶向下法人工依赖性强且更新受限,混合方法则面临模式层构建难度大的困境。无论采用何种路径,高质量KG的构建与维护在垂直领域都是一项沉重的Harness工程。
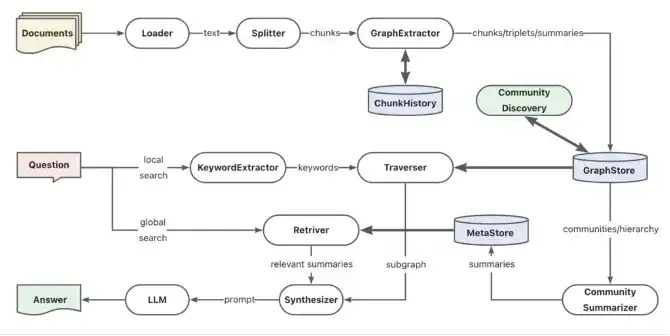
近年的重要演进:动态知识图谱与KG-Agent双向协同。传统KG多为静态构建,而近期EvoReasoner等框架支持从非结构化文档中增量更新知识图谱,实现知识的动态演化。同时,KG与Agent的融合正从“KG增强模型”单向模式,演进为“双向协同”模式,Agent在运行中持续反馈,更新图谱。这为工业场景提供了更灵活的Harness路径,但动态图谱的维护机制与冲突解决策略,仍对企业的知识治理能力提出较高要求。
除上述路线外,预置SQL+向量检索、Text2SQL+预置宽表等务实路径只是以“范围换精度”,缺乏开放式业务Harness,难以支撑Agent的自主决策。
2.3 知识工程的历史回溯:从CommonKADS到Harness设计
技术路线的局限只是表象。回溯专家系统时代,CommonKADS方法论已将知识划分为领域知识、推理知识与任务知识,并针对领域分析、知识建模、知识验证等阶段提出了系统的过程方法。其核心思想是将知识工程视为一个需要系统规划、分层治理的过程,这与今天Harness工程的思路一脉相承。
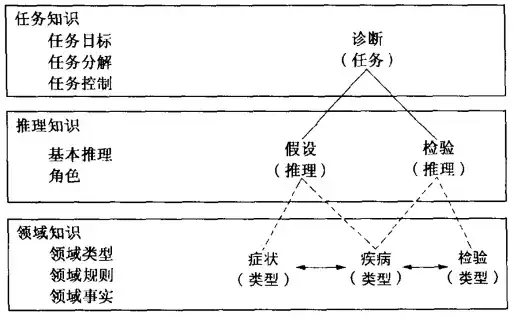
本文讨论的智能问数,就是领域知识层面的Harness工程。这意味着,我们不能依赖RAG、KAG等技术组件的堆砌,而必须回归对业务语义的系统梳理与显性化,将其转化为Agent可执行的约束与契约。
03|实施中的Harness失配与认知误区
Agent问数项目的失败,往往源于三类Harness失配:
3.1 Agent能力与业务Harness的失配
Agent问数应从业务需求中“长”出来,而非拿着技术找场景。从知识工程视角,工业生产系统的知识不可能完全压缩到基础模型;从信息论视角,Agent承载的信息量(模型能力+工具链+约束框架)决定了其决策质量;从决策论视角,业务决策容许的不确定性,必须与Agent执行路径的不确定性相匹配。
Agent擅长处理可被“编码”的数据,但工业领域存在大量难以编码的隐性业务契约。若不能将其显性化为Harness中的硬约束,Agent的行为便不可预期。
3.2 语义层供给与业务需求的失配
普遍认为只要提供足够多的文档资料,Agent就能适配领域。但文档中的信息未必是业务活动所需。以电解铝为例,工区长不会问“氟化盐的作用”等入门问题,他们关心的是中观操控层面的问题(如“当前电解槽不稳的原因”)。这种“供需错位”常造成项目初期的“虚假繁荣”,看似收集了大量文档,面对核心业务需求时却面临“冷启动”。
更深层的问题是,企业现有数据并未为某个岗位或业务活动组织好,缺乏充分的业务语义标注。例如,电流效率计算中的电流应该用槽控机采集的电流还是动力车间的输出电流?槽控参数调整次数的统计条件是槽龄90天以上,而工艺参数合格率的统计条件是槽龄180天以上。这些隐性业务契约散落在经验与代码中,若未在Harness中显式定义,Agent必然出错。
3.3 Harness设计者与业务运营者的对齐难题
现实中缺失既深谙业务细节又掌握Agent工程能力的跨界人才。业务专家缺乏Agent思维,无法系统表达隐性规则;技术专家缺乏业务语境,将数据库表直接作为沟通媒介。这导致大量Harness设计工作被迫推迟到UAT阶段,缺乏系统性与扩展性,项目被迫延期。
04|破局点:将Harness工程前移至规划阶段
综上所述,垂直领域Agent规划必须回答三个问题:①如何选题,选择Agent应用场景?②如何度量实施工作的完整性?③以什么样的交付形式,支撑跨领域协作?
本文的核心主张是:将Harness工程前移至规划阶段,不要留到UAT阶段。Harness工程的核心要义,是构建一个动态系统,以合适形式提供正确的信息、工具与约束,使Agent能够可靠地完成指定任务。本文重点探讨的是业务语义Harness的规划,特别是那些未被文档显性描述的隐性业务契约,包括领域与组织内的约定规则,以及因交流效率不宜要求用户在对话中详述的信息(例如,槽控软件默认过滤掉时长较短的效应,Agent执行时也应遵循该契约)。
因此,本文提出角色Harness(岗位能力分解)与语义Harness(领域模型)双驱动的规划方法:前者从业务角色出发,梳理典型业务活动与决策逻辑,保证Agent能力边界的完整性;后者从领域模型出发,整理共性要素与隐性术语,保证语义约束的完备性。二者相互校验,指导规划阶段的Harness设计。
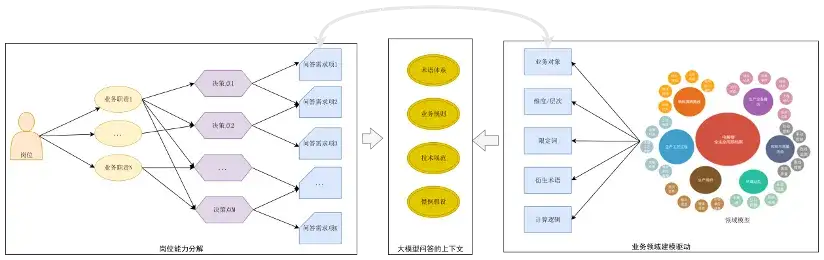
第二篇,我们将先展开第一条驱动路径:如何通过角色Harness,识别Agent真正需要代理的业务决策。
下期见!

